domenica 7 agosto 2016

Creare un biglietto da visita “Social Enabled” in 3 passi


1) Entrando in modifica del nostro profilo Linkedin , possiamo vedere quale sia il link diretto verso di esso :


Selezionando l’icona accanto all' indirizzo pubblico si ha la possibilità di modificarlo per 
renderlo eventualmente più facilmente accomunabile a noi.


2) A questo punto utilizzando un url shortner con facilità è possibile generarne un QR code es. http://goo.gl   
 ( incollare l'indirizzo predisposto per ottenere il QR Code di riferimento )


3) Inseriamo gli elementi ottenuti nel nostro nuovo biglietto da visita ‘social enabled’ e l'opera è conclusa ! Well Done !


Attenzione : nell’utilizzare icone di LinkedIn ricordarsi di riportare che trattasi di marchio registrato 
ed affidarsi alle immagini ed ai colori indicati nelle pagine ufficiale del social https://brand.linkedin.com/downloads


mercoledì 6 luglio 2016

martedì 16 febbraio 2016

Conservazione dei siti web delle P.A.

Formenti Nicolò– rev.1.0 –  https://creativecommons.org/licenses/by-nc-sa/3.0/

La conservazione dei siti Web è una attività che ebbe inizio congiuntamente con la diffusione del World Wide Web al vasto pubblico (avvento dell’HTML); di fatto già dalla metà degli anni novanta nacquero iniziative volte a preservare questo nuovo patrimonio digitale, in particolare nel 1996 venne fondata da Brewster Kahle la “Internet Archive”, una biblioteca digitale non profit con lo scopo dichiarato di consentire un "accesso universale alla conoscenza”. In quegli anni viene coniato il termine “Web Archiving”, come il processo di collezionare parti significative del web per assicurare che le informazioni siano preservate in un archivio a lungo termine per futuri ricercatori, storici, sociologi ed in generale per il pubblico di domani.  Dall’evoluzione dell’esperienza dell’ Internet Archive e con il contributo di diverse biblioteche nazionali ed università, nacque nel 2003 l’ International Internet Preservation Consortium (IIPC).


L’IIPC è de facto il riferimento principale, per quanto riguarda la conservazione delle informazioni sul web, in particolare gli obbiettivi del consorzio sono :
  • Consentire la raccolta, la conservazione e l'accesso a lungo termine di un ricco corpo di contenuti Internet da tutto il mondo.
  • Favorire lo sviluppo e l'uso di strumenti comuni , le tecniche e gli standard per la creazione di archivi internazionali.
  • Essere un forte sostenitore internazionale per le iniziative e la legislazione che incoraggiano la raccolta , la conservazione e l'accesso ai contenuti Internet .
  • Incoraggiare e sostenere le biblioteche , archivi, musei e istituzioni culturali in tutto il mondo per affrontare i contenuti di raccolta e la conservazione di Internet .

Le fasi del Web Archiving

Selection : La scelta delle risorse web che vanno conservate e la frequenza con cui viene operata tale conservazione.
Harvest : La raccolta vera e propria delle informazioni sul web selezionate al punto precedente.
Preservation : La conservazione a lungo termine delle risorse raccolte
Access : La garanzia di poter accedere alla risorsa conservata a lungo termine in futuro

Sono le priorità fondamentali di oggi per poter assicurare il mantenimento delle informazioni di oggi nel futuro. L’archiviazione del Web, sposta negli step più a valle,  il compito di esaminare le risorse, organizzarle, determinarne chiavi di ricerca, indici fulltext ed estrazione di metadati e correlazioni automatiche. Questa attività, che è il fulcro del successo della consultazione dei documenti nei tradizionali processi ‘controllati’ di archivistica, viene effettuata e pianificata già nelle primissime fasi di gestione della risorsa, ovvero, prima che la risorsa web venga decontestualizzata dal suo ambito. Questa sarà una considerazione fondamentale, per portare alla costruzione di risorse web con gli stessi criteri che adottiamo quando formiamo documenti digitali atti alla conservazione a lungo termine; proprio perché tali vogliamo che siano, almeno per quanto riguarda il sottoinsieme di documenti informatici da Pubbliche Amministrazioni.

Al fine di formare documenti informatici web in forma propedeutica alla conservazione, sarà rivolto lo sforzo del legislatore e dei gruppi di lavoro delle entità, che attorno ad esso orbitano.

Il documento informatico sul web

Di fatto la formazione di documenti informatici sul web riferendosi al DPCM 13/11/2014 , avviene in due modalità : la prima (art.3 comma 1 lett.a) tramite l'utilizzo di appositi strumenti software, ove al termine della formazione i medesimi vengono pubblicati sul web; la seconda (art.3 comma 1 lett.d) tramite la generazione o raggruppamento, anche in  via  automatica,  di  un insieme di dati o registrazioni, provenienti da una o piu' basi dati, anche  appartenenti  a  piu'  soggetti  interoperanti,  secondo   una struttura logica predeterminata e memorizzata in forma statica. Il web come oggi è conosciuto rispecchia principalmente la seconda, con alcune specificità che ricadono nella prima.

“Assioma 1 : Un sito web è principalmente un insieme di documenti informatici formati  secondo l’art.3 comma 1 lett.d del DPCM 13/11/2014 e come tale va trattato”

L’assioma è inteso come punto di partenza della trattazione che si andrà sviluppando e non come verità assoluta; nella forma più generale possibile un sito web rientra nella categoria di “Documento interattivo dinamico” secondo le definizioni correnti in materia. L’assioma ha validità laddove si intenda lo scopo della conservazione come la “capacità di ri-creare, o ri-eseguire l’entità in questione” e che implica che “l’autore/produttore sia un partecipante attivo nella conservazione”.
• L’autenticità della risorsa è assicurata dal coinvolgimento dell’autore/produttore nella creazione di un surrogato che riflette le sue intenzioni
• La natura di documento è garantita dal fatto che l’autore/produttore produce il surrogato nel corso ordinario delle sue attività e per gli scopi della sua attività”
L’utilizzo di standard è la base di partenza per raggiungere lo scopo di ri-creare l’entità conservata, così come la minimizzazione delle fonti dinamiche esterne al sito, mentre più facili da trattare sono i dinamismi derivanti dall’uso di basi dati del produttore o i link a risorse esterne persistenti.

Il formato del documento informatico del Web – WARC – ISO 28500

Per le argomentazioni di cui sopra, una rappresentazione di documento informatico idonea alla trattazione di cui all’assioma 1 è il WARC . Il formato WARC ( Web Archive ) specifica un metodo per combinare più risorse digitali in un file di archivio aggregato con le relative informazioni . Le risorse sono datate, identificate da URI e precedute da semplici intestazioni di testo. Per convenzione i file di questo formato hanno estensione " .warc " e tipo MIME “application/warc”.
Il formato di file WARC è una revisione/generalizzazione del formato ARC utilizzato da Internet Archive per archiviare blocchi di informazioni raccolte dai crawler web, durante la fase di ‘harvesting’.
Tale formato, essendo un contenitore anche di altre risorse non è garante della leggibilità nel tempo delle singole risorse in esso contenute; valgono pertanto le stesse implicazioni che si affrontano quando viene trattato un documento informatico in formato RFC 2822/MIME (Mail).

WARC in Action

Esistono diversi strumenti di web-crawling e di rappresentazione delle informazioni archiviate,  purtroppo la veloce evoluzione delle nuove tecnologie rende molto complessa la sfida di riuscire a ricreare con esattezza l’entità conservata.
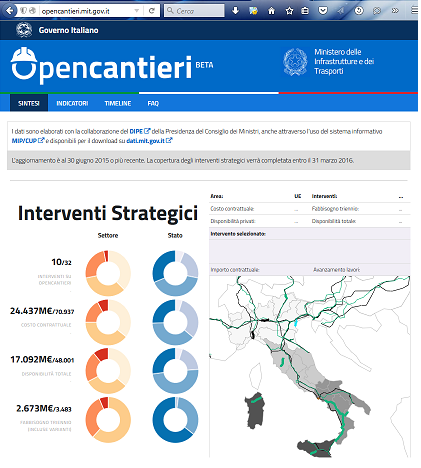
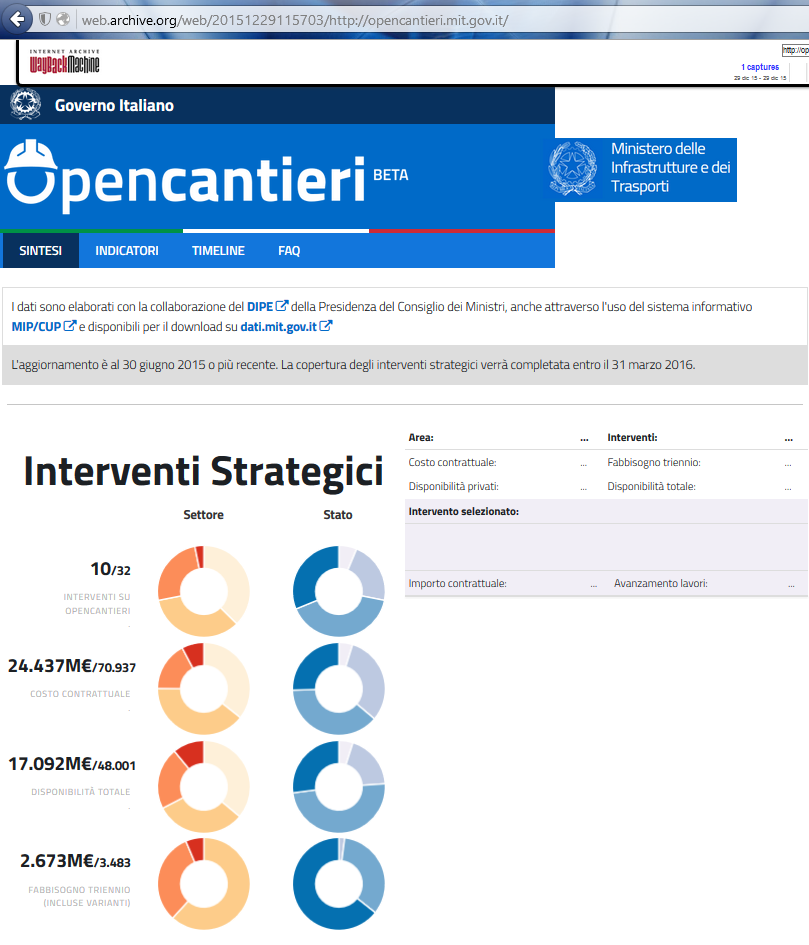
Nell’esempio viene riportato il sito http://opencantieri.mit.gov.it/ alla data del 29/12/2015 realizzato secondo le specifiche di design (in stadio alfa) proposte su http://design.italia.it ; nelle due immagini si osserva ciò che è rappresentato all’utente, nel caso di accesso ‘reale’ al sito e cosa vede l’utente da una rappresentazione del medesimo dal WARC estratto (tratto da http://web.archive.org  Wayback Machine )

Versione originale
Versione riproposta via web.archive.org

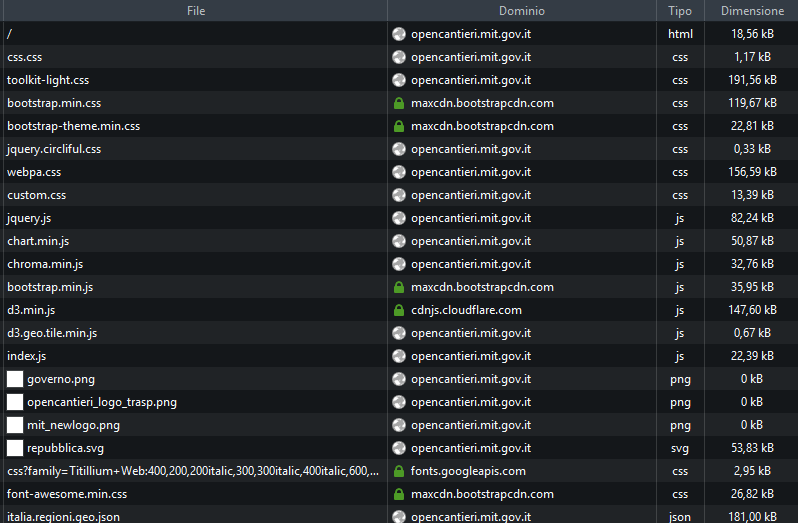
Si nota che non tutti gli elementi sono stati riproposti correttamente. Vediamo ora quali sono gli elementi, in dettaglio che compongono la singola risorsa  “home page di open cantieri”: 
Elementi che compongono la home page di http://opencantieri.mit.gov.it/

Trattasi di un html principale, diversi css, alcune immagini png , una svg, diverse librerie javascript (js) ed un pacchetto dati json (italia.regioni.geo.json). Alcuni elementi vengono forniti da server differenti da quello principale ( maxcdn.bootstrapcdn.com , cdnjs.cloudflare.com …  ).
Il WARC generato deve contenere TUTTI gli elementi che hanno portato alla composizione della pagina. Estraendolo con il servizio https://webrecorder.io/ ed esaminandolo con uno strumento opportuno, osserviamo che in esso tutti gli elementi evidenziati nella figura sono presenti come elementi dell’archivio.

WARC-Target-URI: https://cdnjs.cloudflare.com/ajax/libs/d3/3.5.6/d3.min.js   
WARC-Target-URI: http://opencantieri.mit.gov.it/js/chart.min.js
WARC-Target-URI: http://opencantieri.mit.gov.it/img/repubblica.svg
WARC-Target-URI: http://opencantieri.mit.gov.it/img/opencantieri_logo_trasp.png
WARC-Target-URI: http://opencantieri.mit.gov.it/img/mit_newlogo.png       
WARC-Target-URI: http://opencantieri.mit.gov.it/img/governo.png           
WARC-Target-URI: http://opencantieri.mit.gov.it/data/italia.regioni.geo.json   
WARC-Target-URI: http://opencantieri.mit.gov.it/css/webpa.css           
WARC-Target-URI: http://opencantieri.mit.gov.it/css/toolkit-light.css
...
L’ottenimento di tutti gli elementi necessari alla corretta visualizzazione è l’obiettivo minimale da raggiungere;  così facendo, con l’ausilio di un visualizzatore del WARC che ri-crei l’entità nel modo più verosimile possibile, viene di fatto realizzata la conservazione della risorsa.


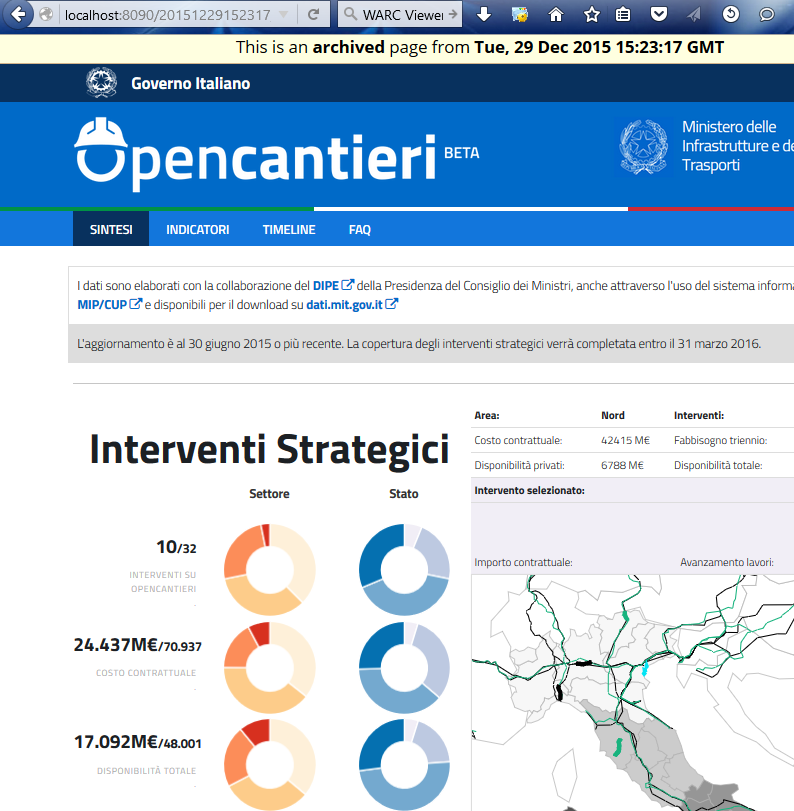
Versione visualizzata dal WARC con Web Archive Player 1.2.0 (pywb 0.10.9.1)


Nell’immagine si vede come la risultanza ottenuta con il viewer Web Archive Player sia decisamente congruente con la versione d’origine, animazioni ed effetti javascript compresi, giacchè tutti gli elementi che compongono la risorsa vengono forniti al browser web in maniera equivalente alla situazione originale. In particolare nella pagina in oggetto, sono stati trasferiti anche i dati necessari (in formato json) per il disegno della mappa e la gestione dell’interattività della stessa; infatti se sulla pagina ricostruita viene selezionata un elemento nella mappa, vengono riportati per esso i dati relativi.

Esempio di interazione con pagina visualizzata dal WARC

Questa è una situazione ideale, ove la risorsa web non necessita di ulteriori interazioni/elementi con la parte server-side per garantire il proprio funzionamento, se non quelle che vengono richieste inizialmente al caricamento della pagina. Purtroppo non è sempre così, in quanto vi sono risorse web ove il colloquio con il server è frequente e non prevedibile, perché frutto delle interazioni che l’utente ha con la risorsa web.  

In generale, si fa una distinzione tra ‘Surface Web’ (o Web di Superficie) e ‘Deep Web’ (o Web Sommerso) , in sintesi si afferma che il ‘Surface Web’ è ciò che si riesce ad indicizzare, mentre il ‘Deep Web’ è composto da tutto ciò che non è possibile indicizzare.
Ad esempio :
  • risorse dinamiche: pagine web dinamiche, il cui contenuto viene generato sul momento dal server, che possono essere richiamati solo compilando un form o a risposta di una particolare richiesta (che citavamo prima);
  • risorse non linkate da altre: pagine Web che non sono collegate a nessun'altra pagina Web.
  • risorse ad accesso ristretto: siti che richiedono una registrazione o comunque limitano l'accesso alle loro pagine impedendo che i motori di ricerca possano accedervi;
  • risorse appositamente anonimizzate … per esempio vedasi The Onion Router

Le risorse del ‘Web Sommerso’, nonostante i passi avanti compiuti dai crawler , ad oggi non risultano essere idonee alla conservazione, così da poterle ri-creare e ri-eseguire fedelmente.

“Assioma 2 : Una risorsa web conservabile a lungo termine, identificata univocamente da un URI (RFC 3986) e da un timestamp (RFC 3339 - ISO 8601), deve poter essere rappresentata in tutte le sue componenti, in modo da poter essere ri-creata e ri-eseguita in maniera equivalente all’originale ”

“Assioma 3 : Una risorsa web di cui all’assioma 2 è un documento informatico che assume la caratteristica di immodificabilità secondo l’art.3 comma 2 del DPCM 13/11/2014”

Conclusione : “Se una risorsa web rappresenta atti, fatti o dati giuridicamente rilevanti, la stessa deve essere conservata, pertanto deve avere le caratteristiche di cui all’assioma 2”


[1] Brewster Kahle è un ingegnere informatico americano, attivista di Internet , sostenitore di un accesso universale a tutta la conoscenza e bibliotecario digitale.Egli è il fondatore di Internet Archive , Internet Archive Federal Credit Union, Alexa e Thinking Machines e membro della Internet Hall of Fame.
[2] DECRETO DEL PRESIDENTE DEL CONSIGLIO DEI MINISTRI 13 novembre 2014 - Regole tecniche in materia di formazione, trasmissione, copia, duplicazione, riproduzione e validazione temporale dei documenti informatici nonche' di formazione e conservazione dei documenti informatici delle pubbliche amministrazioni ai sensi degli articoli 20, 22, 23-bis, 23-ter, 40, comma 1, 41, e 71, comma 1, del Codice dell'amministrazione digitale di cui al decreto legislativo n. 82 del 2005. (15A00107) (GU Serie Generale n.8 del 12-1-2015)
[4] Dall’ allegato 2 – DPCM 13/11/2014 – Sez.5.8 Formati Messaggi di posta elettronica
Ai fini della conservazione, per preservare l’autenticità dei messaggi di posta elettronica, lo
standard a cui fare riferimento è RFC 2822/MIME. Per quanto concerne il formato degli allegati al messaggio, valgono le indicazioni di cui ai precedenti paragrafi. (Ovvero le caratteristiche di Apertura, Sicurezza, Portabilità, Funzionalità, Supporto allo Sviluppo e Diffusione)
[5] La Wayback Machine è un archivio digitale del World Wide Web e altre informazioni su Internet creato da Internet  Archive . E 'stato istituito da Brewster Kahle e Bruce Gilliat , ed è mantenuto con contenuti provenienti da Alexa . Il servizio consente agli utenti di visualizzare le versioni archiviate di pagine web attraverso il tempo , che l'archivio chiama un " indice di tre dimensioni . "
[7] CSS - (Cascading Style Sheets, in italiano fogli di stile) - www.w3.org/TR/CSS
[8] PNG (Portable Network Graphics) – RFC 2083
[9] SVG (Scalable Vector Graphics) - http://www.w3.org/Graphics/SVG
[10] JS – Javascript - Standard ECMA-262 
[11] JSON, acronimo di JavaScript Object Notation, è un formato adatto all'interscambio di dati fra applicazioni client-server - RFC 4627
[12] Il software vero e proprio dedicato alla fase di ‘Harvest’ delle risorse web e che nella nostra trattazione porta partendo da un URI (RFC 3986) specifico alla creazione del rispetto WARC che fotografa la risorsa al momento dell’harvest della stessa. Es. Heritrix
[13] Memorizzato in un sistema di gestione informatica dei documenti o di conservazione la cui tenuta puo' anche essere delegata a terzi (art.3 comma 3del DPCM 13/11/2014)
 

lunedì 23 novembre 2015

Welcome designer.italia.it


Un benvenuto a http://designer.italia.it nella sua prima ‘alfa’ version. E’ stato pubblicato il primo esempio, di come in futuro dovranno essere costruiti i servizi on line per la cittadinanza, da inserirsi nel framework Italia Login del nuovo sistema operativo della PA Italiana

La proposta di Agid, si presenta accompagnandosi con dei MUST molto chiari  ovvero: accessibilità e compatibilità mobile, implementati con il framework Bootstrap e con lo style in forma Sass (Syntactically Awesome Style Sheets).

Lo .zip di esempio, che troviamo sul sito, ci da qualche indicazione anche sulla modalità di sviluppo a “Single Page Application”, orientandoci verso :
* [node e npm] (http://nodejs.org/)
* [Bower] (http://bower.io)
* [Gulp] (http://gulpjs.com/)

L'indicazione del full-stack per sviluppare quindi ci è stata data ... e quindi ora tutti sotto a ‘pigiar tasti’ per realizzare i servizi web del futuro !!!

domenica 4 ottobre 2015

lichess.org - scacchi e opensource

lichess.org è un progetto open source, nato per essere un luogo condiviso e aperto, ove gli scacchisti di tutto il mondo possano confrontarsi, con tecnologie web based, senza plugin aggiuntivi, per ogni device.

Il tutto sancito dal patto di “lichess.org” : 
1. lichess.org sarà sempre gratuito
2. lichess.org non potrà mai contenere pubblicità
3. lichess.org sarà sempre open source

Le tecnologie utilizzate nello stack di sviluppo, sono interessanti, a partire dal chess engine numero 1 al mondo Stockfish, all’utilizzo di MongoDB come repository delle partite (ad oggi oltre 100 Milioni partite di scacchi sono state giocate e memorizzate sulla piattaforma), indicizzate con ElasticSearch.

Lo sviluppo è portato avanti in Scala, usando Play per il routing, template e JSON. (A riguardo ogni elemento è API REST-JSON Compliant quindi facilmente estendibile sotto ogni punto di vista).

Per il “front”, mithril.js è stato preferito ad angular,js per le sua leggerezza tipica.

Tecnicismi a parte la risultanza è essere riusciti a regalare al mondo, la riscoperta di un gioco antico, che nelle partite a distanza ha il suo habitat ( fin dalle mitichepartite per corrispondenza tra Voltaire e Federico II di Prussia!! ), e che come disse Tolstoj: « … obbligano il cervello a funzionare al massimo » e lo tengono in allenamento!

Provatelo e se volete fare qualche partita con me, ben lieto! http://it.lichess.org/@/Nico_Formenti

martedì 1 settembre 2015

Il Sistema Operativo della PA Italiana

Nella riforma PA ci sono le basi per arrivare ad un sistema condiviso e unificato per l’erogazione di servizi digitali alla cittadinanza. I motivi che hanno portato verso questa direzione sono molteplici, e si nascondono anche dietro ai ‘tentativi’ non proprio riusciti del passato.

Spiccano tra questi ‘esercizi’ dai nomi esotici la CEC-PAC ( ovvero la famosa PEC dei cittadini, progetto ritirato definitivamente quest’anno ), la CIE ( la cui adozione è stata annualmente rimandata di anno in anno nei vari decreti mille-proproghe dal 2005 in poi fino alla sua condanna con il DDU ) e progetti di servizi alla cittadinanza in forma condivisa e unificata; ovvero i vari ‘People’ e similari, che non sempre hanno ottenuto il successo di pubblico atteso o che non hanno saputo rispondere tempestivamente alle evoluzioni normative (dal 2008 #ICI-#IMU-#TARI-#TASI-#AdessoLeTogliamo-#PoiLeRimettiamo … ), e soprattutto tecnologiche… abbiamo il 73% di penetrazione dei dispositivi mobile nel 2014 (di cui 40% Smartphone)

Il risultato : Una pesante eredità di 100.000 di siti di servizi pubblici on line completamente differenti con modalità di login distinte, non user friendly, non compatibili con il mobile, e che danno una identità di paese molto frammentata.

E quindi l’obiettivo : partendo dallo SPID si vuole avere un unico punto di accesso per tutti i servizi PA, sia quelli esistenti e sia quelli di nuova generazione, soluzione che sarà in linea con l’avvento del DDU che accompagnerà lo SPID come strumento per l’identificazione del cittadino.

Da tutto ciò nascono i :  
4 PILASTRI FONDAMENTALI DELL' S.O. DELLA PA
- Identità Digitale (SPID)
- Anagrafe Unificata Digitale (ANPR)
- Sistema di notifiche centralizzato per il cittadino (sistema con cui il cittadino viene avvertito degli eventi e dei momenti in cui lo stesso deve interagire con la pubblica amministrazione)
- Sistema dei Pagamenti


lasciando tutto il resto al mercato. Di ciò troviamo conferma anche nella slide ad effetto ( ! )


consapevoli che spesso proprio grazie alle partecipate, gli Enti Pubblici hanno erogato e garantito i servizi digitali  alla cittadinanza, che hanno fatto scuola per arrivare alle conclusioni ed alle direzioni di oggi. Io ritengo che per sopravvivere ed essere efficienti, le partecipate con mandato informatico/tecnologico debbano sempre più allontanarsi dal ruolo di essere direttamente i produttori di soluzioni per i loro enti,  per accostarsi sempre più a quello di  trovare le migliori soluzioni sul mercato ed essere i facilitatori dell’adozione negli enti delle medesime.

In generale, favorendo un “Buy” delle PA ben fatto, a dispetto di un “Make” che nonostante la nobile idea di riuso ( ovvero la possibilità per una pubblica amministrazione di riutilizzare gratuitamente programmi informatici, o parti di essi, sviluppati per conto e a spese di un’altra amministrazione, adattandoli alle proprie esigenze ) non ha portato alle economie e soprattutto, alle qualità sperate. ( Chiaramente la considerazione non vale per tutti i progetti a riuso, è evidente che vi siano state  eccellenze … )

Tornando al main theme del post, ecco quindi la creazione di quello che vuole essere un framework unificato e non solo un portale; un luogo unico dove risiederanno le applicazioni, in primis l’anagrafe, il sistema di notifiche (sia PUSH che Email), il sistema dei pagamenti e del dovuto del cittadino. Un luogo in cui, le applicazioni andranno scritte con delle linee guida ( che si stanno progettando proprio in questi giorni, e che usciranno nei prossimi mesi ); per ottenere così di avere tutti i servizi in una sola pagina e per avere dei servizi che siano il più possibile congruenti tra loro. Punti di Forza : Accessibilità, Esperienza Utente appagante e Orientato e progettato per il Mobile.

CHI FA COSA ?
Il sistema paese è un ecosistema complesso ed eterogeneo, e quindi ciò che cercherà di fare il governo sarà di confluire gli sforzi di tutti gli attori di questo ecosistema verso una direzione comune, con backend as a services definiti ed efficienti, riportati alla tecnologie attuali. I ruoli :


1 - Identity Provider forniscono e assicurano l’identità
2 – I Service Provider  (gli enti / aziende ) che metteranno a disposizione i servizi appoggiando la login degli stessi su SPID
3 – Gli Application Provider saranno coloro, che creeranno i servizi (nello stile responsive / single page application ) sfruttando le API ed i dati a disposizione
4 – I Developer http://developer.italia.it e
che faranno il loro mestiere,  ma in modo condiviso tramite community …


“Who doesn’t work doesn’t eat”
Uzbek, Tashkent, 1920 (Mardjani)

Concludendo un luogo di condivisione semplice ed unico per chi vuole innovare l’Italia. 
( recuperando anche il famoso dominio http://italia.it e dando ad esso un ruolo nuovo e centrale )

COME FARLE ?
Partendo dal Piano di Crescita Digitale (PdCD), è già ben abbozzato il compito di Agid, ovvero fare un master plan di tutto quanto descritto prima, quindi scomporre il piano di crescita in progetti/azioni/tempi, efficentando gli sforzi e rendendoli di facile esecuzione.

Il PdCD, individua 3 ambiti :
1 – I progetti di accelerazione (Italia Login è fra questi perché vuole essere il catalizzatore di tutte le attività che si vanno a collocare)

2 – I progetti infrastrutturali,
a) il primo tra questi è SPID, perché se abbiamo un’identità unica utilizzabili nei siti della
PA e non, abbiamo fatto un primo passo verso la semplificazione.
b) poi abbiamo l’SPC
c) razionalizzazione data center e cloud
d) security

3 – Piattaforme abilitanti, che sono quelle che danno il contenuto ovvero che portano Italia Login alla sua completezza. Quindi sopra i punti citati alla sezione 2) si vanno a costruire i contenuti.

Si evince che esista una sessione relativa ai contenuti per le varie filiere : es. Sanità Digitale, ma anche alcuni altri che sono ormai in fase di attuazione come il nodo dei pagamenti che è stato citato prima. Chiaramente Agid sta operando in parallelo  (a macchia di leopardo) e non serialmente altrimenti per il 2020 non si avrebbe nulla, ma con una logica di coerenza.

Le Priorità : 1°SPID e 2°Pagamenti – Che saranno il primo pezzo di Italia Login
Il 3° è il look&feel di Italia.Login ovvero la sua brandizzazione, il senso di unitarietà, una usabilità coerente tra i vari servizi della PA, perché in Italia l’utilizzo dei servizi della PA è molto basso, e forse non solo per la poca propensione dei cittadini della PA, ma anche a causa del fatto che i servizi sono il porting in digitale di procedure vetuste ed obsolete, e che diventano nel mondo dei bytes ancora più complesse ed inutilizzabili. Quindi il 3° filone attuale è la stesura di linee guida di accesso e semplificazione dei servizi alla cittadinanza.

A CHE PUNTO SIAMO ?


SPID
-          Completamento regole tecniche per la selezione degli identity provider (che saranno società private che sulle regole di Agid garantiranno il servizio di IP) – Con il garante della privacy si è stato in corsa per pubblicarle entro l’estate - FATTO
-          A quel punto con l’arrivo delle domande degli IP, ci sarà una selezione da parte di Agid così da avere un elenco di IP con il quale iniziare a lavorare
-          Parallelamente sulle bozze di regole tecniche sono iniziate le sperimentazioni in quanto abbiamo sperimentatori sia nell’ambito degli IP che dei fornitori di servizi che stanno andando bene
-          Quindi terminata la fase burocratica e di selezione degli IP, le PA sperimentatrici avranno già dei servizi pronti all’uso via SPID

PAGAMENTI

-          Il Nodo pagamenti già funziona, ci sono  230 su 20000 PA che lo utilizzano, è un hub di backend su cui Agid punta molto. (rif. http://www.agid.gov.it/tags/nodo-pagamenti ) è qualcosa su cui si vuole spingere tantissimo ‘entro l’anno’ per creare massa critica

Avere a quel punto Identità e Pagamenti attivi, significherà avere uno zoccolo duro su cui far entrare servizi veri. Ma ci vogliono sinergie, come chiedere ad una PA di smontare tutti i suoi servizi per farli andare verso SPID e Nodo Pagamenti, se non ha già un sistema a layer ed unificato; significa mettere in gioco un grosso sforzo, anche organizzativo.

Look&Feel

– L’obiettivo non è portare tutto su Italia Login e togliere la visibilità agli enti locali, però vanno date regole minime di progettazione e definizione dei siti, in modo che almeno 2 dei fondamentali requirements siano rispettati : Accessibilità (esiste la legge), Siti Responsive per la Funzionalità in Mobile


PROSPETTIVE 

Prendiamo come esempio la fatturazione elettronica; essendo un obbligo normativo, tutti si sono adeguati, si è creato un grosso spazio di mercato; la Fattura PA ha fatto comprendere che non sono più sostenibili, soluzioni informatiche vetuste e raffazzonate, ma ci troviamo ormai su un terreno che si apre verso soluzioni integrate, rivisitazione dei sistemi contabili, ove Agid e nessuna altra istituzione possono arrivare, ma ove invece, è il mercato che può e deve saper rispondere. In modo analogo, si aprono opportunità di mercato con l’integrazione del sistema di pagamenti e con la creazione di servizi a valore aggiunto implementando SPID, o con la grande sfida del documento digitale, tutte occasioni che possono essere sfruttate da coloro che sono pronti a cogliere queste opportunità, e da chi ha capito che la crescita del nostro paese non può prescindere dal processo di Innovazione della Pubblica Amministrazione.